데이터가 여러 개라는 이유만으로 모두 같은 목록에 넣을 수는 있다. 하지만 번호로 자주 찾는지, 중간 삽입이 많은지, 부모·자식이나 여러 연결 관계가 중요한지에 따라 알맞은 자료구조가 달라진다.
아래 그림은 같은 A·B·C도 접근 방식과 관계에 따라 배열·연결 리스트·트리·그래프로 달라지는 모습을 보여 준다.
배열과 연결 리스트는 무엇이 다를까?
array는 같은 종류의 값을 연속된 인덱스로 관리하는 구조다. 인덱스로 특정 위치를 읽기 쉽지만, 중간에 값을 넣거나 빼면 주변 요소를 이동해야 할 수 있다.
linked list는 각 node가 값과 다음 노드를 가리키는 link를 가진다. 이미 노드 위치를 알고 있다면 연결을 바꾸어 삽입·삭제할 수 있지만, n번째 값을 찾으려면 앞에서부터 링크를 따라가야 한다.
| 질문 | 배열 | 연결 리스트 |
|---|---|---|
| 인덱스로 자주 접근 | 적합한 경우가 많음 | 앞에서 순회해야 함 |
| 중간 삽입·삭제 | 요소 이동 가능 | 링크 변경 가능 |
| 메모리 특성 | 연속 배치와 캐시 이점 가능 | 링크 저장 비용과 비연속 배치 가능 |
언어의 list라는 이름이 실제로 연결 리스트라는 뜻은 아니다. 예를 들어 동적 배열을 List라고 부르는 구현도 있으므로 내부 구조와 복잡도를 확인한다.
tree와 graph는 관계를 어떻게 표현할까?
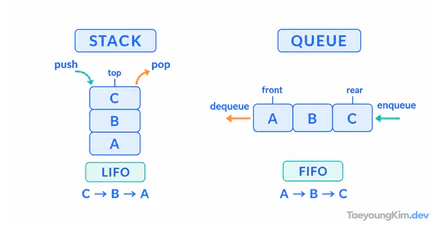
tree는 보통 하나의 루트에서 부모·자식 관계가 뻗는 계층 구조다. 파일 디렉터리나 문서 목차처럼 한 경로로 내려가는 관계에 잘 맞는다.
graph는 vertex(node)와 edge로 여러 방향의 연결을 표현한다. 소셜 관계, 도로망, 서비스 의존성처럼 한 대상이 여러 대상과 연결될 수 있다.
트리는 그래프의 한 형태로 볼 수 있지만, 모든 그래프가 트리는 아니다. 순환이 있는지, 방향이 있는지, 한 노드에 여러 부모가 가능한지에 따라 탐색과 오류 처리도 달라진다.
search sort traversal은 어떤 동작일까?
search는 원하는 값을 찾고, sort는 정해진 기준으로 순서를 재배열한다. traversal은 구조의 노드를 일정한 규칙으로 방문한다.
트리와 그래프에서는 깊이 우선 탐색(DFS)과 너비 우선 탐색(BFS)을 자주 비교한다. DFS는 한 경로를 깊게 따라가고, BFS는 가까운 단계부터 넓게 방문한다. 어떤 것이 항상 빠른 것이 아니라 찾으려는 대상과 그래프 크기, 메모리 제약에 따라 선택한다.
Big-O는 실제 시간을 뜻할까?
Big-O는 입력 크기가 커질 때 시간이나 공간 사용량이 어떻게 증가하는지 나타내는 점근 표기다. O(1), O(log n), O(n), O(n²)처럼 증가 경향을 비교한다.
같은 O(n)이어도 실제 시간은 언어, 메모리 배치, 입력 크기와 상수 비용에 따라 다르다. 반대로 작은 데이터에서 빠른 구현이 큰 데이터에서도 유리하다고 단정할 수 없다. 복잡도는 측정값이 아니라 선택 후보를 좁히는 모델이며, 중요한 경로는 실제 입력으로 측정한다.
자료구조를 선택할 때 어떤 질문부터 할까?
- 가장 자주 하는 동작이 조회, 삽입, 삭제, 순회 중 무엇인가?
- 순서가 중요한가, 키로 찾는가, 관계를 따라가는가?
- 데이터 크기의 상한과 메모리 제약은 무엇인가?
- 중복, 순환, 동시 수정이 가능한가?
- 사용하는 언어의 실제 구현과 복잡도는 무엇인가?
핵심 요약
배열은 인덱스 접근, 연결 리스트는 링크 기반 삽입·삭제, 트리는 계층 관계, 그래프는 일반적인 연결 관계를 표현한다. 이름이나 모양보다 자주 수행하는 동작과 관계를 기준으로 고른다. Big-O로 증가 경향을 비교하되 실제 구현과 입력으로 검증해야 한다.