테이블에 인덱스를 만들면 중복이 사라지고, 트랜잭션을 쓰면 모든 동시성 문제가 해결된다고 생각하기 쉽다. 데이터 구조, 탐색 경로, 무결성, 작업 단위를 담당하는 용어를 나눠야 설계 판단이 정확해진다.
아래 그림은 행을 식별하는 키, 찾는 경로인 인덱스와 변경을 확정하거나 되돌리는 트랜잭션을 한 흐름으로 구분한다.
table row column은 데이터를 어떻게 표현할까?
관계형 데이터베이스의 table은 같은 속성 구조를 가진 데이터 집합을 표현한다. row는 한 개의 레코드, column은 각 레코드가 가진 속성이다.
users(id, email, team_id)
teams(id, name)schema는 테이블, 열, 타입, 제약조건과 관계 같은 데이터 구조의 정의다. 실제 저장된 행과 스키마 정의를 구분해야 마이그레이션과 데이터 변경을 다르게 다룰 수 있다.
primary key foreign key는 무엇을 보장할까?
primary key는 테이블의 각 행을 고유하게 식별한다. foreign key는 한 테이블의 값이 다른 테이블의 후보키·기본키와 유효한 관계를 갖도록 참조 무결성을 만든다.
기본키가 있다고 업무상 모든 중복이 막히는 것은 아니다. 사용자 이메일도 고유해야 한다면 별도 UNIQUE 제약이 필요할 수 있다. 외래키도 삭제 시 제한, 연쇄 삭제, null 허용 같은 정책을 함께 정해야 한다.
index는 제약조건이나 정렬 결과와 같은가?
index는 특정 열이나 표현식의 값을 빠르게 찾기 위한 보조 자료구조다. 읽기 성능을 높일 수 있지만 저장 공간과 쓰기 갱신 비용이 든다.
인덱스가 있다고 SELECT 결과 순서가 자동 보장되지는 않는다. 정렬이 필요하면 ORDER BY를 명시한다. UNIQUE 인덱스가 제약 구현에 쓰일 수는 있지만 일반 인덱스 자체가 업무 중복을 막는 규칙은 아니다.
쿼리 조건, 데이터 분포, 선택도와 실행 계획을 확인하지 않고 모든 열에 인덱스를 추가하면 쓰기 비용만 커질 수 있다.
normalization은 왜 테이블을 나눌까?
normalization은 데이터 중복과 삽입·수정·삭제 이상을 줄이기 위해 속성과 관계를 정리하는 과정이다. 팀 이름을 모든 사용자 행에 반복 저장하면 이름 변경 시 여러 행을 빠뜨릴 수 있다. teams 테이블로 분리하고 team_id로 연결하면 한 곳에서 관리할 수 있다.
반대로 조회 성능이나 분석 목적 때문에 중복을 허용하는 denormalization을 선택할 수 있다. 이때는 어느 값이 원본이며 어떻게 동기화할지 정해야 한다.
transaction과 concurrency control은 무엇을 지킬까?
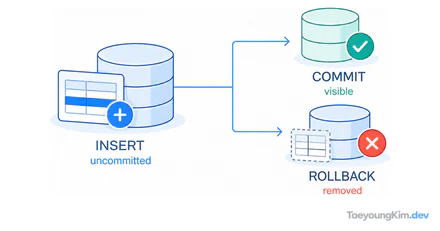
transaction은 함께 성공하거나 실패해야 하는 데이터 작업의 단위다. commit은 변경을 확정하고 rollback은 확정 전 작업을 되돌린다.
동시에 여러 트랜잭션이 같은 데이터를 읽고 수정하면 lost update, dirty read 같은 문제가 생길 수 있다. lock, 격리 수준, 다중 버전 동시성 제어(MVCC) 등은 동시 접근의 결과를 통제한다.
SAVEPOINT는 한 트랜잭션 안에서 부분 롤백 지점을 만든다. 데이터베이스 CHECKPOINT는 복구를 위해 로그와 데이터 페이지의 기준을 만드는 다른 개념이다.
핵심 요약
테이블·행·열은 데이터 구조, 키와 제약조건은 식별과 무결성, 인덱스는 탐색 경로, 정규화는 중복과 이상 현상 관리, 트랜잭션은 함께 확정할 작업 단위를 담당한다. 이름이 비슷하거나 같은 기능에 함께 쓰여도 맡는 책임은 다르므로 스키마, 제약, 실행 계획과 동시성 정책을 각각 확인하자.